
Erupt Cube 指标平台
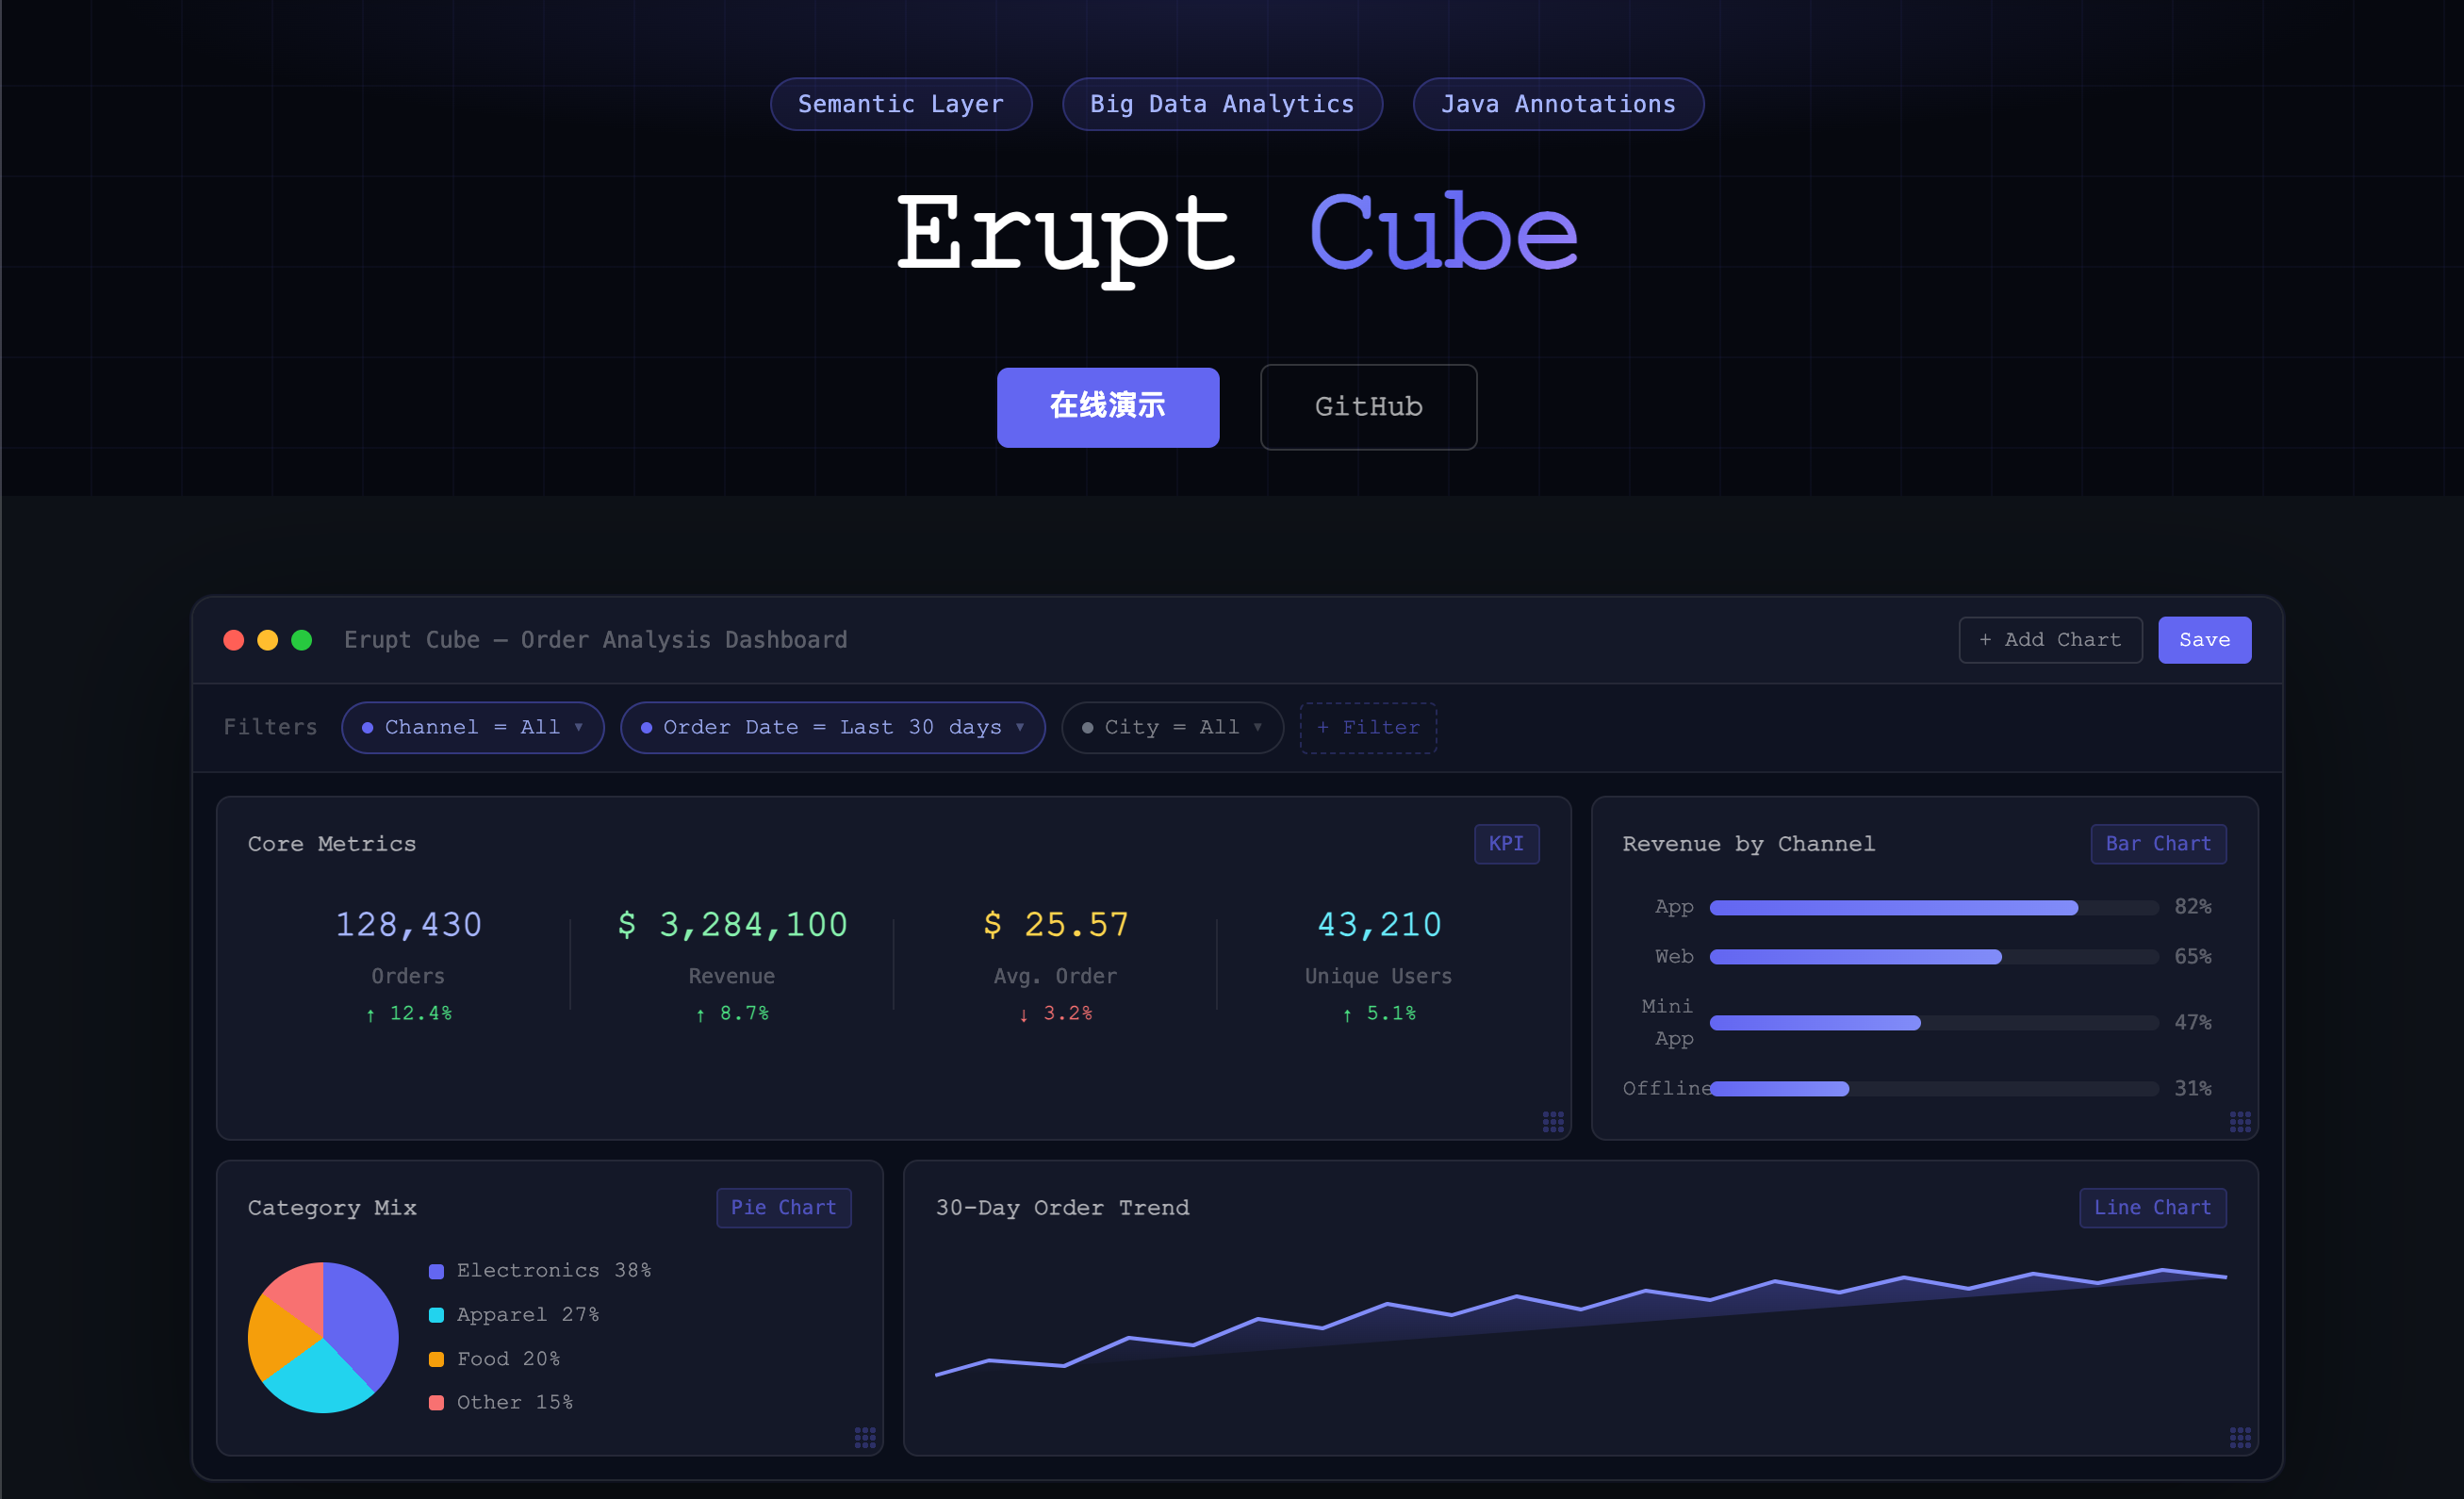
借鉴 Google Looker 的语义层理念,为 Java 生态打造专业级大数据分析方案。数据工程师专注模型构建,数据分析师基于语义层自助完成可视化,无需多方协作,注解定义语义模型 + 拖拽完成可视化,开箱即用。
商业模块
包含:完整源码 · 全版本升级 · 技术支持 · erupt 相关问题优先支持 · 合理需求免费实现 · 能力持续迭代 授权:无 License 限制 · 无项目数量限制 · 无商用限制 限制:禁止二次开源与分发
由开源 Erupt 框架团队官方出品与维护(GitHub 3k+ ★ · Gitee 5k+ ★),避免 Kylin / Looker 等方案的厂商锁定与运维成本。
演示:https://demo.erupt.xyz 账号:cube 密码:cube
语义模型解决什么问题
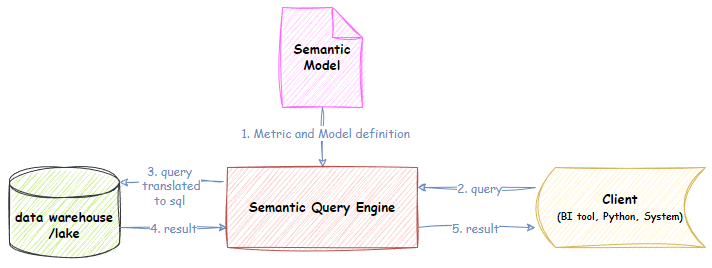
数据源接入后由 @EruptCube 统一定义维度与指标,所有消费端共享同一套语义:
| 问题 | 没有语义模型 | 有语义模型 |
|---|---|---|
| 指标口径 | 每个人写的 SQL 不一样 | 统一定义,一处修改处处生效 |
| 使用门槛 | 必须懂 SQL | 拖拽即用 |
| 复用性 | 逻辑散落在各报表 | 集中定义,随处复用 |
| 可维护性 | 改表结构要改所有 SQL | 只改模型层即可 |
两种建模方式:注解 + 可视化 互补
erupt-cube 同时支持两种语义模型定义方式,覆盖团队内不同角色:
| 方式 | 适用人 | 能力 | 适用场景 |
|---|---|---|---|
| Java 注解建模(主) | 开发工程师 / 数据工程师 | 完整能力,覆盖所有维度、指标、关系、自定义 SQL、动态字段 | 复杂模型、版本化随代码管理、需要 Code Review |
| 可视化界面建模(辅) | 数据分析师 / 业务人员 | 常用维度、指标、关系配置(能力略少于注解) | 临时性 / 探索性建模、非 Java 角色快速试错 |
两种方式可在同一项目内共存:复杂核心模型用注解定义并 git 管理,业务侧临时分析用可视化建模快速验证,提需求时再由开发同学把可视化模型沉淀为注解。
推荐工作流:注解定义核心模型 → 可视化界面用于业务自助探索 → 探索后稳定下来的模型回流为注解。
注解建模速查(API 参考)
一个语义模型 = 一个 @EruptCube 类,类上定义底表 SQL 与对外查询视图(Explore),字段上用 @Dimension / @Measure 声明维度与指标。下面是一个可直接编译的完整示例(源自 xyz.erupt.project.cube.WorkItemStatsCube):
@Getter
@Setter
@EruptCube(
        name = "Work Item Statistics",
        sql = """
                select wi.type         as type,
                       wi.status       as status,
                       u.name          as assignee_name,
                       wi.story_points as story_points,
                       wi.due_date     as due_date
                from e_project_work_item wi
                         left join e_upms_user u on wi.assignee_id = u.id
                """
)
public class WorkItemStatsCube {

    @Dimension(title = "Assignee", sql = "assignee_name")
    private String assigneeName;

    @Dimension(title = "Status", sql = "status")
    private String status;

    @Dimension(title = "Due Date", sql = "due_date")
    private LocalDate dueDate;

    @Measure(title = "Work Item Count", sql = "count(*)")
    private Long workItemCount;

    @Measure(title = "Overdue Count",
             sql = "sum(case when status <> 'DONE' and due_date < current_date then 1 else 0 end)")
    private Long overdueCount;

    @Measure(title = "Story Points", sql = "sum(story_points)")
    private Double storyPoints;
}@EruptCube(类级)
| 属性 | 类型 | 说明 |
|---|---|---|
name | String | 模型名称(必填) |
datasource | String | 数据源 key,留空使用主数据源 |
description | String | 模型描述 |
sql | String | 底表 SQL,按 sqlType 解释为子查询或表名(支持 VTL 模板) |
sqlType | SqlType | SUB_QUERY(默认)/ TABLE_NAME |
explores | Explore[] | 对外暴露的查询视图,默认含一个 overview |
prompt | String | 提供给 AI 的提示词(markdown) |
tags | String[] | 标签 |
dataProxy | Class<? extends CubeProxy>[] | 查询前后钩子 |
@Dimension(字段级 · 维度)
| 属性 | 类型 | 说明 |
|---|---|---|
title | String | 维度显示名(必填) |
type | FieldType | AUTO(默认,按字段类型推断)/ NUMBER / STRING / DATE |
sql | String | GROUP BY 列表达式,默认取字段名(支持 VTL) |
prompt | String | AI 提示词 |
hidden | boolean | 是否隐藏 |
tags | String[] | 标签 |
@Measure(字段级 · 指标)
| 属性 | 类型 | 说明 |
|---|---|---|
title | String | 指标显示名(必填) |
type | FieldType | 同上 |
sql | String | 聚合 SQL 表达式,如 sum(amount)(必填) |
drillFields | String[] | 下钻时暴露的明细维度字段 |
drillFilter | String | 下钻时追加的过滤条件 |
prompt | String | AI 提示词 |
hidden | boolean | 是否隐藏 |
tags | String[] | 标签 |
@Explore(查询视图)
定义一个 cube 对外的若干种查询视角,每个 code 对应一组可用维度 / 指标。
| 属性 | 类型 | 说明 |
|---|---|---|
code | String | 视图唯一编码 |
name | String | 视图名称 |
where | String | 该视图的固定过滤条件 |
dimensions | String[] | 该视图暴露的维度(留空为全部) |
measures | String[] | 该视图暴露的指标(留空为全部) |
parameters | ExploreParameter[] | 运行时参数 |
joins | Join[] | 与其它 cube 的关联 |
hidden | boolean | 是否隐藏 |
CubeProxy(扩展点)
实现 xyz.erupt.annotation.fun.CubeProxy 并在 @EruptCube(dataProxy = ...) 中引用,可在查询表达式生成前后各插一手(行级权限、租户隔离、结果加工):
public interface CubeProxy {

    // 查询表达式生成前动态处理
    default String beforeQuery(String expr, Map<String, Object> context) {
        return expr;
    }

    // 查询结果返回后处理
    default void afterQuery(List<CubeResultRow> result, Map<String, Object> context) {
    }
}
关于注解字符串在 IDE 里如何获得 SQL / VTL 语法高亮与校验,见专题 《注解里的那行字符串,不是哑字符串》。
为什么不用 Looker / Metabase / Cube.dev / 自研?
| 维度 | Looker (Google) | Metabase | Cube.dev | 自研 SQL 拼接 | Erupt Cube |
|---|---|---|---|---|---|
| 语义层定义方式 | LookML(专用 DSL) | Models(GUI 配置) | YAML / JS Schema | 无(散落在各报表 SQL) | Java 注解(主)+ 可视化界面(辅) |
| 语言生态 | LookML(要单独学) | Java / Clojure(闭源核心) | Node.js / TypeScript | Java | Java(与业务工程同一栈) |
| 部署形态 | SaaS(闭源) | 独立服务(Docker) | 独立服务 | 与业务一体 | 与业务工程一体 |
| 与权限体系集成 | 重新对接 | 自有用户体系,要同步 | 不含权限 | 自研 | 复用 Erupt UPMS,零成本 |
| 厂商绑定 | 重度(Google) | 否(但社区版功能受限) | 否 | 否 | 否(源码交付) |
| 国产数据库支持 | 几乎没有 | 一般 | 一般 | 看实现 | 达梦 / 人大金仓 / OceanBase 等 |
| 价格区间 | $5,000+ / 月起 | 开源 + 企业版收费 | 开源 + Cloud 收费 | 0(人力成本除外) | 一次买断 · 查看定价 |
数据库支持
| 类型 | 产品 |
|---|---|
| 分析型数仓(OLAP) | Apache Doris、StarRocks、ClickHouse、GreenPlum、Apache Hive、Presto、Trino、Impala、ADB |
| 关系型数据库(OLTP) | MySQL、PostgreSQL、Oracle、SQL Server、TiDB |
| 国产数据库 | 达梦(DM)、人大金仓(KingbaseES)、OceanBase |
| 云原生数仓 | Redshift、Snowflake、BigQuery、Databricks、阿里云 MaxCompute、华为云 DWS |
与 Google Looker 的关系
Looker 将语义层理念做到极致,称之为 LookML,核心思想是:所有指标逻辑只定义一次,所有报表共享同一套语义层。Erupt Cube 用 Java 注解替代 LookML 的 DSL,对 Java 开发者更友好,无需学习新语言,且可深度集成 Erupt 体系内的权限、菜单、租户能力。
适合谁
- 中型企业数据团队(要 BI 但没数据工程师编制)
- 咨询公司 / 数据交付商(每个项目都要交付几十个看板)
- 传统行业数字化部门(要 OLAP 但不想踩 Kylin / Looker 的坑)
- 已在用 Erupt 开源版的团队(无缝升级,权限自然继承)
常见问题
Q1 · 和开源版 erupt 有什么差异? 开源 erupt 提供基础 CRUD、表单与简单报表能力。erupt-cube 是商业模块,引入完整的语义层 + 多数据源 + 拖拽分析 + 看板能力 —— 这部分开源版不包含、且未来也不会开源。
Q2 · 和 erupt-report 是什么关系?
- erupt-report:基于 SQL 直接配置图表,适合有 SQL 能力的开发者快速搭建固定报表
- erupt-cube:基于语义层的 BI 平台,适合数据分析师拖拽自助分析,覆盖更复杂的 OLAP 场景
二者可独立使用,也可同时使用(chart 服务开发者,cube 服务业务分析师)。团队规模大、有专职数据分析师,建议直接上 cube。
Q3 · 怎么交付? 付款后,提供你的 GitHub 用户名,作者会把你加入私有仓库 erupts/erupt-cube 的 collaborator,可直接 clone 源码、本地编译、按需引用,并发一份接入文档。
Q4 · 后续版本升级要再付费吗? 不需要。一次买断 = 你拥有当前及所有未来版本的访问权。私有仓库的 master 持续更新,git pull 即可。
Q5 · 项目数量 / 商用 / 转手怎么算?
- 无项目数量限制:你公司内部、你接的外包项目,部署多少个都不限
- 无商用限制:可用于商业产品(含二次销售你的成品,但不可直接卖 erupt-cube 源码本身)
- 转手:禁止二次开源、禁止源代码再分发;公司更名或主体变更可申请授权迁移
Q6 · 试用 / 退款?在线演示 已开放完整功能(账号 cube / 密码 cube),建议先充分体验。开通仓库权限后视为交付完成,不再支持退款。
如有未列出问题,请前往 定价与购买页面 联系作者咨询。
贡献者
 YuePeng
 Claude Opus 5 (1M context)